GROMACS
GROMACS on erittäin tehokas ohjelmisto molekyylidynamiikkasimulaatioiden ja energian minimoinnin suorittamiseen erityisesti proteiineille. Sitä voidaan kuitenkin käyttää myös polymeerien, kalvojen ja esimerkiksi karkeistetun tason järjestelmien mallintamiseen. Lisäksi sen mukana tulee runsaasti analyysiskriptejä.
Saatavuus
| Versio | Saatavilla olevat moduulit | Huomautukset |
|---|---|---|
| 2025.1 | gromacs/2025.1 |
CPU-versio |
| 2025.2 | gromacs/2025.2 |
CPU-versio |
| 2025.3 | gromacs/2025.3 |
CPU-versio |
| 2025.4 | gromacs/2025.4 |
CPU-versio |
| 2026.0 | gromacs/2026.0 |
CPU-versio |
| 2026.1 | gromacs/2026.1 |
CPU-versio |
| Versio | Saatavilla olevat moduulit | Huomautukset |
|---|---|---|
| 2025.1 | gromacs/2025.1 |
GPU-versio |
| 2025.2 | gromacs/2025.2 |
GPU-versio |
| 2025.3 | gromacs/2025.3 |
GPU-versio |
| 2025.4 | gromacs/2025.4 |
GPU-versio |
| 2026.0 | gromacs/2026.0 |
GPU-versio |
| 2026.1 | gromacs/2026.1 |
GPU-versio |
| Versio | Saatavilla olevat moduulit | Huomautukset |
|---|---|---|
| 2025.1 | gromacs/2025.1gromacs/2025.1-gpugromacs/2025.1-heffte |
GPU-tuettu moduuli saatavilla heFFTeä sisältävä moduuli saatavilla GPU PME -hajotelmaa varten |
| 2025.2 | gromacs/2025.2gromacs/2025.2-gpu |
GPU-tuettu moduuli saatavilla |
| 2025.3 | gromacs/2025.3gromacs/2025.3-gpu |
GPU-tuettu moduuli saatavilla |
| 2025.4 | gromacs/2025.4gromacs/2025.4-gpugromacs/2025.4-heffte |
GPU-tuettu moduuli saatavilla heFFTeä sisältävä moduuli saatavilla GPU PME -hajotelmaa varten |
| 2026.0 | gromacs/2026.0gromacs/2026.0-gpu |
GPU-tuettu moduuli saatavilla |
| 2026.1 | gromacs/2026.1gromacs/2026.1-gpugromacs/2026.1-heffte |
GPU-tuettu moduuli saatavilla heFFTeä sisältävä moduuli saatavilla GPU PME -hajotelmaa varten |
Huomautukset
- Roihussa on myös
gromacs-env/<year>-moduuleja, joilla voi ladata kunkin vuoden uusimman aliversion (korvaa<year>vastaavasti). -
Jotta pääset käyttämään moduuleja LUMIssa, lataa ensin CSC:n moduulipuu käyttöön komennolla:
-
Versioiden 2025.0 ja sitä uudempien pitäisi tukea PLUMEDia oletuksena. Jos haluat käyttää PLUMEDia, lataa lisäksi PLUMED-moduuli.
- Tarjoamme vain MPI-version
gmx_mpi, mutta sitä voidaan käyttää myös komennoillegrompp,editconfjne. samaan tapaan kuin sarjaversiota. Komennongmx gromppsijaan annagmx_mpi grompp.
Lisenssi
GROMACS on vapaata ohjelmistoa, joka on saatavilla LGPL-lisenssillä, versio 2.1.
Käyttö
Alusta GROMACSin suositeltu versio Roihussa näin:
Käytä komentoa module spider muiden versioiden löytämiseen. Näiden moduulien lataamiseksi sinun täytyy ensin ladata vaaditut riippuvuudet, jotka näytetään komennolla module spider gromacs/<version>.
Jotta voit käyttää CSC:n GROMACS-moduuleja LUMIssa, muista suorittaa ensin:
Rajoita simulaatioaikaa käyttämällä -maxh
Käytäthän mdrun-komennon kanssa -maxh-valitsinta. Kun asetat sen yhtä suureksi tai hieman pienemmäksi kuin pyydetty aikaraja (tunneissa), simulaatiolle jää aikaa kirjoittaa viimeinen checkpoint ja päättyä hallitusti ennen kuin Slurm lopettaa työn.
Jos tämä jätetään määrittämättä, on mahdollista, että työ kaataa solmun tai solmut, joilla se on käynnissä. Yleisiä vinkkejä pitkien simulaatioiden hallintaan löytyy GROMACS-käsikirjasta.
Yleisiä huomioita
Minimoi I/O
Minimoi tarpeeton levy-I/O – älä koskaan aja runsassanallisia simulaatioita käyttäen mdrun -v -valitsinta!
On tärkeää määrittää simulaatiot oikein, jotta resursseja käytetään tehokkaasti.
- Jos ajat rinnakkaisesti, tee skaalautuvuustesti jokaiselle järjestelmälle – älä käytä enempää ytimiä/GPU:ita kuin on tehokasta. Skaalautuvuus riippuu monista järjestelmäsi ominaisuuksista ja käytetyistä algoritmeista, ei vain koosta.
- Käytä tuoretta versiota – vuosien varrella on tullut merkittäviä nopeusparannuksia ja virheenkorjauksia. Jos vaihdat pääversion, muista tarkistaa, että tulokset ovat vertailukelpoisia.
- Suurissa CPU-töissä käytä kokonaisia solmuja (Roihussa 384 ytimen monikertoja tai LUMIssa 128 ytimen monikertoja). Katso esimerkit alta.
- GPU-suorituskyky riippuu monista tekijöistä ja siitä, mitä laskentaa siirrät GPU:lle. Katso yleiskuva ENCCS:n verkkomateriaaleista tai GROMACS on LUMI -työpajan materiaaleista, miten ajaa tehokkaasti LUMI-G:llä.
- LUMI-G:llä on tärkeää varmistaa, että CPU:t on sidottu oikeisiin GPU:ihin viestintäylikuorman minimoimiseksi. Katso esimerkit alta ja lisätietoja LUMI Docsista.
Täydellisempi kuvaus löytyy GROMACS-käsikirjan mdrun-suorituskyvyn tarkistuslistasta.
Roihu
#!/bin/bash
#SBATCH --time=00:15:00
#SBATCH --partition=small
#SBATCH --nodes=1
#SBATCH --ntasks-per-node=192
#SBATCH --account=<project>
# this script runs a 192-core (half a node, no hyperthreading) gromacs
# job, requesting 15 minutes time
module purge
module load gromacs-env
export OMP_NUM_THREADS=1
srun gmx_mpi mdrun -s topol -maxh 0.2
#!/bin/bash
#SBATCH --time=00:15:00
#SBATCH --partition=medium
#SBATCH --nodes=1
#SBATCH --ntasks-per-node=192
#SBATCH --cpus-per-task=2
#SBATCH --account=<project>

# this script runs a 384-core (one full node, no hyperthreading) gromacs
# job, requesting 15 minutes time and 192 tasks per node, each with 2
# OpenMP threads

module purge
module load gromacs-env

export OMP_NUM_THREADS=${SLURM_CPUS_PER_TASK}

srun gmx_mpi mdrun -s topol -maxh 0.2
#!/bin/bash
#SBATCH --time=00:15:00
#SBATCH --partition=gpumedium
#SBATCH --nodes=1
#SBATCH --ntasks-per-node=1
#SBATCH --cpus-per-task=72
#SBATCH --gres=gpu:gh200:1
#SBATCH --account=<project>

# this script runs a single-GPU gromacs job, requesting 1 task per GPU,
# 72 OpenMP threads per task and 15 minutes time

module purge
module load gromacs-env

export OMP_NUM_THREADS=${SLURM_CPUS_PER_TASK}
export GMX_ENABLE_DIRECT_GPU_COMM=1
export GMX_FORCE_GPU_AWARE_MPI=1

srun gmx_mpi mdrun -s topol -maxh 0.2 -nb gpu -bonded gpu -pme gpu -update gpu
#!/bin/bash
#SBATCH --time=00:15:00
#SBATCH --partition=gpumedium
#SBATCH --nodes=1
#SBATCH --ntasks-per-node=4
#SBATCH --cpus-per-task=72
#SBATCH --gres=gpu:gh200:4
#SBATCH --account=<project>

# this script runs a full GPU node gromacs job, requesting 1 task per GPU,
# 72 OpenMP threads per task and 15 minutes time

module purge
module load gromacs-env

export OMP_NUM_THREADS=${SLURM_CPUS_PER_TASK}
export GMX_ENABLE_DIRECT_GPU_COMM=1
export GMX_FORCE_GPU_AWARE_MPI=1

srun gmx_mpi mdrun -s topol -maxh 0.2 -nb gpu -bonded gpu -pme gpu -update gpu -npme 1
LUMI
Terminologia
Jokainen LUMIn GPU koostuu kahdesta AMD Graphics Compute Die (GCD) -yksiköstä. Koska solmua kohden on neljä GPU:ta ja Slurm tulkitsee jokaisen GCD:n erilliseksi GPU:ksi, voit varata enintään 8 "GPU:ta" solmua kohden. Lisätietoja löytyy LUMI Docsista.
#!/bin/bash
#SBATCH --partition=small-g
#SBATCH --account=<project>
#SBATCH --time=00:15:00
#SBATCH --nodes=1
#SBATCH --gpus-per-node=1
#SBATCH --ntasks-per-node=1
#SBATCH --cpus-per-task=7

module use /appl/local/csc/modulefiles
module load gromacs/2025.4-gpu

export OMP_NUM_THREADS=${SLURM_CPUS_PER_TASK}

srun gmx_mpi mdrun -s topol -nb gpu -bonded gpu -pme gpu -update gpu -maxh 0.2
#!/bin/bash
#SBATCH --partition=standard-g
#SBATCH --account=<project>
#SBATCH --time=00:15:00
#SBATCH --nodes=1
#SBATCH --gpus-per-node=8
#SBATCH --ntasks-per-node=8

module use /appl/local/csc/modulefiles
module load gromacs/2025.4-gpu

export OMP_NUM_THREADS=7

export MPICH_GPU_SUPPORT_ENABLED=1
export GMX_ENABLE_DIRECT_GPU_COMM=1
export GMX_FORCE_GPU_AWARE_MPI=1

cat << EOF > select_gpu
#!/bin/bash

export ROCR_VISIBLE_DEVICES=\$SLURM_LOCALID
exec \$*
EOF

chmod +x ./select_gpu

CPU_BIND="mask_cpu:fe000000000000,fe00000000000000"
CPU_BIND="${CPU_BIND},fe0000,fe000000"
CPU_BIND="${CPU_BIND},fe,fe00"
CPU_BIND="${CPU_BIND},fe00000000,fe0000000000"

srun --cpu-bind=${CPU_BIND} ./select_gpu gmx_mpi mdrun -s topol -nb gpu -bonded gpu -pme gpu -update gpu -npme 1 -maxh 0.2
Huomioita sidonnasta ja usean GPU:n simulaatioista LUMIssa
Vain tietyt CPU-ytimet on LUMIssa kytketty suoraan tiettyyn GPU:hun, joten usean GPU:n suorituskyvyn maksimoimiseksi on tärkeää varmistaa, että CPU-ytimet sidotaan GPU:ihin tämän mukaisesti. Yllä oleva koko GPU-solmun esimerkki huolehtii tästä ja jättää lisäksi pois jokaisen tiettyyn GCD:hen kytketyn 8 ytimen ryhmän ensimmäisen ytimen. Ne on varattu käyttöjärjestelmälle häiriöiden vähentämiseksi, mikä tarkoittaa, että solmua kohden on käytettävissä vain 56 ydintä. Siksi ajamme myös 7 säiettä MPI-rankia kohden emmekä 8:aa.
CPU-GPU-sidonta vaatii yksinomaisen käytön
Huomaa, että CPU-GPU-sidonta toimii vain, kun varataan kokonaisia solmuja ajamalla standard-g-osiolla tai käyttämällä --exclusive-valitsinta. Lisätietoja löytyy LUMI Docsista:
Sen sijaan, että GPU:t kommunikoisivat CPU:n kautta, suora GPU-kommunikaatio tuo merkittäviä suorituskykyetuja myös usealla GPU:lla ajettaessa. Tämän käyttöönotto edellyttää seuraavien ympäristömuuttujien asettamista eräajokomentosarjaasi (katso myös yllä oleva koko GPU-solmun esimerkki):
export MPICH_GPU_SUPPORT_ENABLED=1
export GMX_ENABLE_DIRECT_GPU_COMM=1
export GMX_FORCE_GPU_AWARE_MPI=1
Suorituskyvyn yleiskatsaus
Alla on yleiskatsaus GROMACS 2026.1:n suorituskykyyn Roihussa ja LUMIssa. Käytössä on STMV-benchmark (1067k atomia, 2 fs aikasteppi). Huomaa, että jokainen LUMIn GPU sisältää kaksi fyysistä GPU-laitetta (GCD:t), ja alla oleva kuvaaja viittaa nimenomaan GPU:ihin.

Pienet järjestelmät ja suuren läpimenon simulaatiot
Huomaa, että yllä oleva benchmark on suuri järjestelmä, joka skaalautuu hyvin useille CPU-solmuille ja GPU:ille. Pienemmät järjestelmät (<100k atomia) eivät välttämättä pysty hyödyntämään useita tai edes yhtä GPU:ta tehokkaasti, jolloin suositellaan useiden simulaatioiden ajamista yhtä GPU:ta kohden. Tämä voidaan toteuttaa käyttämällä GROMACSin sisäänrakennettua -multidir-ominaisuutta.
Katso tämä opas suuren läpimenon simulaatioiden ajamiseen GROMACSilla.
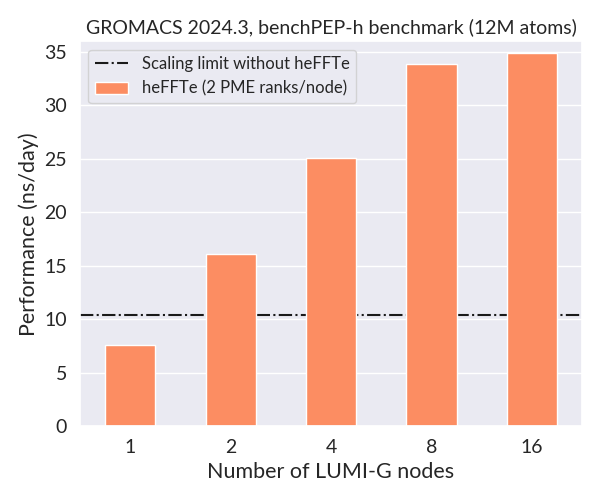
GPU PME -hajotelma
Useiden miljoonien atomien erittäin suurten järjestelmien skaalautuvuutta voi rajoittaa yhden GPU:n PME. Skaalautuvuuden merkittäväksi parantamiseksi PME-työn hajottaminen useille GPU:ille on mahdollista LUMIssa moduuleissa, joiden pääte on -heffte ja jotka on linkitetty heFFTe-kirjastoon. Lisää seuraavat export-komennot eräajokomentosarjaasi:
Käytettävien PME-rankien määrä riippuu tapauksesta, mutta 1 tai 2 GPU-solmua kohden pitäisi olla järkevä lähtökohta. Joten 16 LUMI-G-solmulle kokeile -npme 16 tai -npme 32. Esimerkkibenchmark on esitetty alla.
GPU PME -hajotelma Roihussa
Roihusta puuttuu tällä hetkellä moduuli, joka mahdollistaisi GPU PME -hajotelman. Se lisätään mahdollisimman pian.
Visualisointi ja analyysi
GROMACSin trajektoritiedostoja ja dataa voidaan visualisoida esimerkiksi seuraavilla ohjelmilla:
- VMD -visualisointiohjelma suurille biomolekulaarisille järjestelmille
- Grace GROMACS-työkaluilla tuotetun datan piirtämiseen
- MDAnalysis Python-kirjasto MD-simulaatioiden trajektorien analysointiin
- Ei saatavilla CSC:llä, mutta käyttäjä voi asentaa sen helposti kontitetussa Conda-ympäristössä Tykyllä
- PyMOL molekyylimallinnusjärjestelmä (ei saatavilla CSC:llä)
Lisää on lueteltu GROMACS-käsikirjassa. Lisäksi GROMACS itse sisältää lukuisia jälkikäsittelytyökaluja trajektorien analysointiin. Katso lisätiedot komentoriviviitteestä.
Raskaiden/pitkien analyysien ajaminen
Suurten trajektorien visualisointi sekä tietyt GROMACS-työkaluskriptit voivat olla laskennallisesti erittäin vaativia, eikä niitä tule koskaan ajaa kirjautumissolmuilla (katso käyttöehdot). Aja tällaiset kuormat sen sijaan interactive-istunnossa. Koska tarjoamme vain GROMACSin MPI-version, sinun täytyy lisätä gmx_mpi-komentosi eteen prterun -n 1, esimerkiksi näin:
sinteractive --account <project>
module load gromacs-env
prterun -n 1 gmx_mpi msd -n index -s topol -f traj
Koska useimmat GROMACSin analyysityökalut, kuten yllä oleva msd-työkalu, voidaan ajaa vain sarjamuodossa, ne voivat kestää varsin pitkään suurilla trajektoreilla. Tällaisissa tapauksissa voi olla kätevämpää ajaa työkalut sarja-ajon eräajotöinä. Jos komento, jonka haluat ajaa, vaatii vuorovaikutusta (esimerkiksi sen valitsemista, mitkä järjestelmäsi osat sisällytetään analyysiin), voit välittää nämä eräajotyössä esimerkiksi näin:
# Three consecutive selections (options 2, 2 and 0), you need to know these beforehand
echo "2 2 0" | gmx_mpi trjconv -f traj -s topol -o trajout -pbc cluster -center
Huomaa, että voit käyttää longrun-osiota (aikaraja 10 päivää), jos small-osion 3 päivän aikaraja ei riitä. Sen prioriteetti on hyvin matala, ja sen käyttö vaatii usein huomattavaa jonotusta. Toinen käyttökelpoinen vaihtoehto on käyttää selainkäyttöliittymien kautta saatavaa pysyvää laskentasolmun komentotulkkia, joka pysyy käynnissä, vaikka sulkisit selaimen tai internetyhteys katkeaisi.
Viitteet
Viittaa työhösi seuraavilla lähteillä:
- S. Páll, A. Zhmurov, P. Bauer, M. J. Abraham, M. Lundborg, A. Gray, B. Hess, E. Lindahl. Heterogeneous parallelization and acceleration of molecular dynamics simulations in GROMACS. J. Chem. Phys. 153 (2020) pp. 134110.
- M. J. Abraham, T. Murtola, R. Schulz, S. Páll, J. C. Smith, B. Hess, E. Lindahl. GROMACS: High performance molecular simulations through multi-level parallelism from laptops to supercomputers. SoftwareX 1 (2015) pp. 19-25.
- S. Páll, M. J. Abraham, C. Kutzner, B. Hess, E. Lindahl. Tackling Exascale Software Challenges in Molecular Dynamics Simulations with GROMACS. In S. Markidis & E. Laure (Eds.), Solving Software Challenges for Exascale 8759 (2015) pp. 3-27.
- S. Pronk, S. Páll, R. Schulz, P. Larsson, P. Bjelkmar, R. Apostolov, M. R. Shirts, J. C. Smith, P. M. Kasson, D. van der Spoel, B. Hess, and E. Lindahl. GROMACS 4.5: a high-throughput and highly parallel open source molecular simulation toolkit. Bioinformatics 29 (2013) pp. 845-54.
- B. Hess and C. Kutzner and D. van der Spoel and E. Lindahl. GROMACS 4: Algorithms for highly efficient, load-balanced, and scalable molecular simulation. J. Chem. Theory Comput. 4 (2008) pp. 435-447.
- D. van der Spoel, E. Lindahl, B. Hess, G. Groenhof, A. E. Mark and H. J. C. Berendsen. GROMACS: Fast, Flexible and Free. J. Comp. Chem. 26 (2005) pp. 1701-1719.
- E. Lindahl and B. Hess and D. van der Spoel. GROMACS 3.0: A package for molecular simulation and trajectory analysis. J. Mol. Mod. 7 (2001) pp. 306-317.
- H. J. C. Berendsen, D. van der Spoel and R. van Drunen. GROMACS: A message-passing parallel molecular dynamics implementation. Comp. Phys. Comm. 91 (1995) pp. 43-56.
Katso simulaatiosi lokitiedostosta tarkemmat viitteet menetelmille, joita asetuksissasi on käytetty.
Lisätietoja
- GROMACSin kotisivu ja dokumentaatio
- mdrun-suorituskyvyn tarkistuslista
- Materiaaleja BioExcelin verkkosivustolla
- GROMACS-yhteisöfoorumi
- Juliste GROMACSin suorituskyvystä LUMIssa
- Koulutusmateriaalit:
- Opastusmateriaalit:
- Esimerkki-
.tpr-tiedostoja testausta varten: