GROMACSin suurteholaskenta
Huomio
Suurtehosimulaatiot voivat helposti tuottaa paljon dataa, joten suunnittele tutkimusdatanhallinta (datan kulku, tallennustarpeet) ja analyysiputket etukäteen. Älä epäröi ottaa yhteyttä CSC:n asiakastukeen, jos olet epävarma työnvuosi jostakin osa-alueesta.
GROMACSissa on sisäänrakennettu multidir-toiminnallisuus,
jonka avulla käyttäjät voivat ajaa useita samanaikaisia simulaatioita yhden
Slurm-varauksen sisällä. Tämä on erinomainen vaihtoehto suurtehokäyttötapauksiin,
joissa tavoitteena on ajaa useita samankaltaisia mutta toisistaan riippumattomia
töitä. Huomionarvoista on, että useita sbatch- tai srun-kutsuja ei tarvita,
mikä vähentää kuormaa eräjonoihin. Harkitse tätä vaihtoehtoa, jos ajat
suurtehotyövuoita tai tehostetun näytteistyksen töitä, kuten replica exchange
- tai vapaaenergiasimulaatioita, joissa käytetään ensemble-pohjaisia etäisyys-
tai orientaatiorajoitteita.
multidir-toiminnallisuuden toinen hyöty on, että sitä voidaan käyttää pienten
järjestelmien rinnakkaistehokkuuden parantamiseen. Käynnistämällä useita
trajektoreita GPU:ta (tai CPU-solmua) kohden kunkin riippumattoman simulaation
yhteenlaskettu läpimeno kasvaa resurssien paremman hyödyntämisen ansiosta. Tämä
on erityisen hyödyllistä pienten järjestelmien suorituskyvyn maksimoimiseksi
Roihu-GPU:ssa ja LUMI-G:ssä.
Esimerkkieräajokomennostot
Tässä esimerkissä mukautetaan tuotanto-osa
lysozyme-opetusmateriaalista
tarkastelemalla järjestelmästä 8 samankaltaista kopiota, jotka on
tasapainotettu eri nopeusalkuarvoilla. Kutakin kopiota vastaavat syötteet
on nimetty samalla tavalla md_0_1.tpr ja sijoitettu alihakemistoihin
run*, kuten alla oleva tree-komennon tuloste havainnollistaa.
$ tree
.
├── multidir.sh
├── run1
│   └── md_0_1.tpr
├── run2
│   └── md_0_1.tpr
├── run3
│   └── md_0_1.tpr
├── run4
│   └── md_0_1.tpr
├── run5
│   └── md_0_1.tpr
├── run6
│   └── md_0_1.tpr
├── run7
│   └── md_0_1.tpr
└── run8
    └── md_0_1.tpr
#!/bin/bash
#SBATCH --time=00:30:00
#SBATCH --partition=medium
#SBATCH --account=<project>
#SBATCH --nodes=1
#SBATCH --ntasks-per-node=384

# this script runs a 384 core GROMACS multidir job
# (8 simulations, 48 cores per simulation)

module purge
module load gromacs-env

export OMP_NUM_THREADS=1

srun gmx_mpi mdrun -multidir run* -s md_0_1.tpr -dlb yes
Kun ylähakemistossa suoritetaan sbatch multidir.sh, kaikki simulaatiot
ajetaan samanaikaisesti yhdellä täydellä Roihu-CPU-solmulla ilman
hyperthreadingia siten, että kullekin järjestelmälle varataan 48 ydintä.
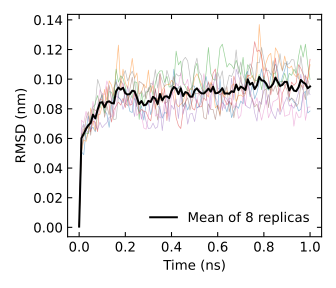
Koska järjestelmät alustettiin eri nopeuksilla, saadaan 8 erillistä
trajektoria ja parempi faasiavaruuden näytteistys (katso RMSD-analyysi
alla). Tämä on erinomainen tapa nopeuttaa näytteistystä, jos järjestelmäsi
ei skaalaudu koko Roihu-CPU-solmulle.
Suuret järjestelmät (>1 miljoona atomia) pystyvät yleensä hyödyntämään useita GPU:ita tehokkaasti. Monet pienemmät käyttötapaukset voivat toimia hyvin myös yhdellä GPU:lla, mutta mitä pienempi järjestelmä on, sitä heikommin se pystyy hyödyntämään kiihdyttimen koko kapasiteettia.
multidir-ominaisuutta voidaan käyttää pienten järjestelmien GPU-käytön
lisäämiseen ajamalla useita trajektoreita GPU:ta kohden. Alla on
esimerkkieräajokomentosarja, joka käynnistää 8 trajektoria GPU:ta kohden
täydellä Roihu-GPU-solmulla (4 GPU:ta). Kukin 32 .tpr-tiedostosta on
nimetty samalla tavalla topol.tpr ja järjestetty erillisiin hakemistoihin
run1–run32, samoin kuin Roihu-CPU-esimerkissä.
CUDA Multi-Process Service
CUDA Multi-Process Servicen (MPS) käyttö on pakollista, jotta useat CUDAa käyttävät MPI-prosessit voivat ajaa samanaikaisesti yhdellä GPU:lla Roihussa. Katso käyttöesimerkki alla olevasta eräajokomentosarjasta.
#!/bin/bash
#SBATCH --time=00:15:00
#SBATCH --partition=gpumedium
#SBATCH --account=<project>
#SBATCH --nodes=1
#SBATCH --ntasks-per-node=32
#SBATCH --cpus-per-task=9
#SBATCH --gres=gpu:gh200:4

module purge
module load gromacs-env

export OMP_NUM_THREADS=${SLURM_CPUS_PER_TASK}
export GMX_ENABLE_DIRECT_GPU_COMM=1
export GMX_FORCE_GPU_AWARE_MPI=1

# NVIDIA CUDA Multi-Process Service (MPS) required to run multiple tasks per GPU
nvidia-cuda-mps-control -d

srun gmx_mpi mdrun -s topol -nb gpu -bonded gpu -pme gpu -update gpu -multidir run*

echo quit | nvidia-cuda-mps-control
Huomaa, että pyytämiesi MPI-tehtävien määrän on oltava riippumattomien syötteiden määrän monikerta, tässä tapauksessa 1 tehtävä syötettä kohden. Koska Roihu GPU:ta kohden on käytettävissä 72 CPU-ydintä, käytämme 9 säiettä tehtävää kohden.
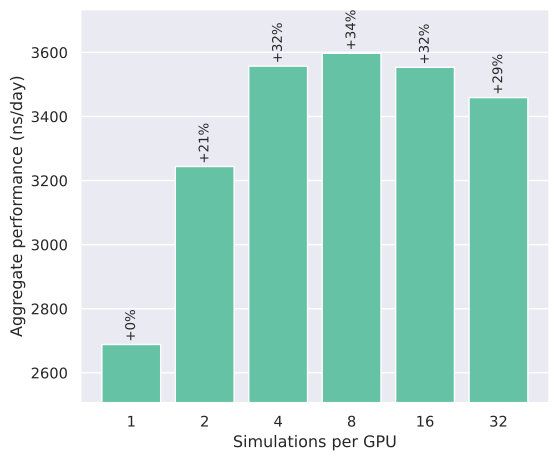
Alla oleva kuvaaja näyttää kokonaisyhteenlasketun läpimenon, joka saadaan, kun 96k atomin alcohol dehydrogenase (ADH) -vertailutapauksen useita replikoita ajetaan täydellä Roihu-GPU-solmulla (2 fs aikasteppi). Kun trajektorien määrä GPU:ta kohden kasvatetaan yhdestä kahdeksaan, aggregoitu suorituskyky (kunkin riippumattoman trajektorin summa) kasvaa noin 34 % GPU:n paremman hyödyntämisen ansiosta. Koska kukin simulaatio on riippumaton, tämän käyttötapauksen voisi skaalata valtavaan määrään solmuja maksimaalisen läpimenon saavuttamiseksi.
Alla oleva esimerkki käynnistää 7 trajektoria MI250X GCD:tä kohden täydellä
LUMI-G-solmulla (8 GCD:tä). Kukin .tpr-tiedosto on järjestetty erillisiin
hakemistoihin run1–run56, samoin kuin Roihu-GPU-esimerkissä.
#!/bin/bash
#SBATCH --time=01:00:00
#SBATCH --partition=standard-g
#SBATCH --account=<project>
#SBATCH --nodes=1
#SBATCH --gpus-per-node=8
#SBATCH --ntasks-per-node=56

module use /appl/local/csc/modulefiles
module load gromacs/2026.1-gpu

export OMP_NUM_THREADS=1
export MPICH_GPU_SUPPORT_ENABLED=1
export GMX_ENABLE_DIRECT_GPU_COMM=1
export GMX_FORCE_GPU_AWARE_MPI=1

cat << EOF > select_gpu
#!/bin/bash

export ROCR_VISIBLE_DEVICES=\$((SLURM_LOCALID%SLURM_GPUS_PER_NODE))
exec \$*
EOF

chmod +x ./select_gpu

CPU_BIND="mask_cpu:fe000000000000,fe00000000000000"
CPU_BIND="${CPU_BIND},fe0000,fe000000"
CPU_BIND="${CPU_BIND},fe,fe00"
CPU_BIND="${CPU_BIND},fe00000000,fe0000000000"

srun --cpu-bind=${CPU_BIND} ./select_gpu gmx_mpi mdrun -s topol -nb gpu -bonded gpu -pme gpu -update gpu -multidir run*
Huomaa, että pyytämiesi MPI-tehtävien määrän on oltava riippumattomien syötteiden määrän monikerta, tässä tapauksessa 1 tehtävä syötettä kohden. Koska LUMI-G-solmulla on käytettävissä vain 56 CPU-ydintä, käytämme yhtä säiettä tehtävää kohden.
CPU-GPU-sidonta LUMIssa
Lisätietoja CPU-GPU-sidonnasta on GROMACS-sovellussivulla, sekä LUMIn käyttöoppaassa.
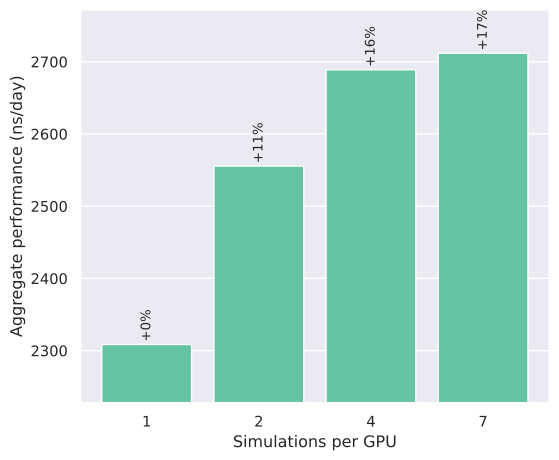
Alla oleva kuvaaja näyttää kokonaisyhteenlasketun läpimenon, joka saadaan, kun 96k atomin alcohol dehydrogenase (ADH) -vertailutapauksen useita replikoita ajetaan yhdellä LUMI-G-solmulla (2 fs aikasteppi). Kun trajektorien määrä GCD:tä kohden kasvatetaan yhdestä seitsemään, aggregoitu suorituskyky (kunkin riippumattoman trajektorin summa) kasvaa noin 17 % GPU:n paremman hyödyntämisen ansiosta. Koska kukin simulaatio on riippumaton, tämän käyttötapauksen voisi skaalata valtavaan määrään solmuja maksimaalisen läpimenon saavuttamiseksi.