Amber
Amber on molekyylidynamiikkaohjelmistopaketti, joka sisältää useita lisätyökaluja kehittyneempään analyysiin ja erityisesti NMR-rakenteiden hienosäätöön.
Saatavuus
| Versio | Saatavilla olevat moduulit |
|---|---|
| 26 | amber/26 |
| 24 | amber/24 |
| Versio | Saatavilla olevat moduulit |
|---|---|
| 26 | amber/26 |
| 24 | amber/24 |
| Versio | Saatavilla olevat moduulit |
|---|---|
| 24 | amber/24-cpuamber/24-gpu |
Lisenssi
Amberia voivat käyttää CSC:n palvelimilla kaikkien voittoa tavoittelemattomien instituuttien ja yliopistojen tutkijat kansallisuudesta tai sijainnista riippumatta. Katso akateemisen lisenssin teksti täältä.
AmberTools on maksuton ja kaikkien käytettävissä. Sen komponentit on enimmäkseen julkaistu GNU General Public License (GPL) -lisenssillä, kun taas osa on public domain -lisenssin piirissä tai muiden avoimen lähdekoodin lisenssien alaisia. Katso lisätietoja AmberToolsin kotisivulta.
Käyttö
Katso saatavilla olevat versiot ja miten Amber ladataan suorittamalla:
LUMIssa sinun täytyy lisätä CSC:n moduulit moduulipolkuusi ennen yllä olevan komennon suorittamista:
module load -komento asettaa $AMBERHOME-muuttujan ja lisää Amberin ja
AmberToolsin binäärit polkuun. Amber-moduulin lataaminen lataa myös
automaattisesti uusimman AmberTools-moduulin (python-ambertools/26.0
Roihussa ja ambertools/26.0 LUMIssa, katso
alla).
Suorita Amberin tuotantoajot eräjonoissa, katso alla. Hyvin kevyt järjestelmän valmistelu (sarjamuotoiset AmberTools-ajot, jotka kestävät muutaman sekunnin ja käyttävät tuskin lainkaan muistia) voidaan tehdä myös kirjautumissolmulla. Raskaammat analyysit kannattaa suorittaa esimerkiksi interaktiivisessa laskentaistunnossa.
Molekyylidynamiikka-ajot kannattaa suorittaa Roihu-GPU:ssa käyttäen
pmemd.cuda- tai pmemd.cuda.MPI-ohjelmaa (monen GPU:n ajoihin), sillä ne
ovat paljon nopeampia GPU:illa kuin CPU:illa. Vastaavasti LUMIssa kannattaa
käyttää pmemd.hip- tai pmemd.hip.MPI-ohjelmaa, mikä edellyttää -gpu-päätteisen
moduulin lataamista.
Suorita GPU-osioissa vain GPU-yhteensopivia binäärejä. Jos olet epävarma,
tarkista komennolla seff <slurm_jobid>, että GPU:ita todella käytettiin ja
että työ valmistui merkittävästi nopeammin kuin ilman GPU:ita. Jos ajat usealla
GPU:lla, varmista, että työ skaalautuu (katso
suorituskyvyn tarkistuslista).
AmberToolsin Python-työkalut
Monet AmberToolsin apuohjelmat perustuvat Pythoniin. Roihussa ne tarjotaan
kontitettuna
Conda-ympäristönä
python-ambertools-moduulin kautta. Amber-moduulin lataaminen lataa myös
automaattisesti AmberTools-moduulin. Voit ladata sen myös erikseen:
Asennuksen kontittaminen välttää suurten Conda-ympäristöjen heikon suorituskyvyn Lustre-rinnakkaistiedostojärjestelmässä, kun ympäristö koostuu valtavasta määrästä pieniä tiedostoja. Kontitettujen työkalujen käyttö ei edellytä mitään erityisiä vaiheita, vaan komentoja voidaan ajaa tavalliseen tapaan, esimerkiksi:
module load amber/26
MMPBSA.py -O -i mmpbsa.in -cp complex.prmtop -rp receptor.prmtop -lp ligand.prmtop -y prod.nc
Huom.
Älä suorita mitään raskasta kirjautumissolmulla! Katso lisätietoja käyttöehdoista. Paljon resursseja käyttävät prosessit tulee suorittaa eräajoina tai interaktiivisessa istunnossa.
LUMIssa vastaava kontitettu AmberTools-asennus on saatavilla ambertools-moduulina.
Se latautuu myös automaattisesti, kun lataat Amber-moduulin. Lataa se erikseen
suorittamalla:
Esimerkkieräskriptit
#!/bin/bash
#SBATCH --account=<project>
#SBATCH --partition=small
#SBATCH --time=01:00:00
#SBATCH --nodes=1
#SBATCH --ntasks=1
#SBATCH --mem-per-cpu=2000M

# The non-GPU-aware binaries, e.g. AmberTools, can be run as batch jobs in
# the following way:

export OMP_NUM_THREADS=${SLURM_CPUS_PER_TASK:-1}

module purge
module load amber/26

srun paramfit -i Job_Control.in -p prmtop -c mdcrd -q QM_data.dat
#!/bin/bash
#SBATCH --account=<project>
#SBATCH --partition=gpumedium
#SBATCH --time=01:00:00
#SBATCH --nodes=1
#SBATCH --ntasks-per-node=1
#SBATCH --cpus-per-task=1
#SBATCH --gres=gpu:gh200:1

# Our tests show that for medium-sized systems the most efficient setup is
# one GPU card and one CPU core.

export OMP_NUM_THREADS=${SLURM_CPUS_PER_TASK:-1}

module purge
module load amber/26

srun pmemd.cuda -O -i mdin.GPU -o mdout.GPU -p Cellulose.prmtop -c Cellulose.inpcrd
#!/bin/bash
#SBATCH --account=<project>
#SBATCH --partition=gpumedium
#SBATCH --time=01:00:00
#SBATCH --nodes=1
#SBATCH --ntasks-per-node=4
#SBATCH --cpus-per-task=1
#SBATCH --gres=gpu:gh200:4

# Please ensure your job is able to utilize multiple GPUs efficiently!

export OMP_NUM_THREADS=${SLURM_CPUS_PER_TASK:-1}

module purge
module load amber/26

srun pmemd.cuda.MPI -O -i mdin.GPU -o mdout.GPU -p Cellulose.prmtop -c Cellulose.inpcrd
#!/bin/bash
#SBATCH --account=<project>
#SBATCH --partition=small-g
#SBATCH --time=01:00:00
#SBATCH --nodes=1
#SBATCH --ntasks-per-node=1
#SBATCH --gpus-per-node=1

# Our tests show that for medium-sized systems the most efficient setup is
# one GPU card and one CPU core.

export OMP_NUM_THREADS=${SLURM_CPUS_PER_TASK:-1}

module use /appl/local/csc/modulefiles
module load amber/24-gpu

srun pmemd.hip -O -i mdin.GPU -o mdout.GPU -p Cellulose.prmtop -c Cellulose.inpcrd
#!/bin/bash
#SBATCH --account=<project>
#SBATCH --partition=standard-g
#SBATCH --time=01:00:00
#SBATCH --nodes=1
#SBATCH --ntasks-per-node=8
#SBATCH --gpus-per-node=8

# Please ensure your job is able to utilize multiple GPUs efficiently!

export OMP_NUM_THREADS=${SLURM_CPUS_PER_TASK:-1}
export MPICH_GPU_SUPPORT_ENABLED=1

module use /appl/local/csc/modulefiles
module load amber/24-gpu

cat << EOF > select_gpu
#!/bin/bash

export ROCR_VISIBLE_DEVICES=\$SLURM_LOCALID
exec \$*
EOF

chmod +x ./select_gpu

CPU_BIND="mask_cpu:fe000000000000,fe00000000000000"
CPU_BIND="${CPU_BIND},fe0000,fe000000"
CPU_BIND="${CPU_BIND},fe,fe00"
CPU_BIND="${CPU_BIND},fe00000000,fe0000000000"

srun --cpu-bind=$CPU_BIND ./select_gpu pmemd.hip.MPI -O -i mdin.GPU -o mdout.GPU -p Cellulose.prmtop -c Cellulose.inpcrd
Suorituskykyhuomioita
Jos Amberin suorituskyky ei ole riittävä, harkitse GROMACSin käyttöä, sillä se pystyy yleensä skaalautumaan pidemmälle (eli hyödyntämään enemmän CPU- ja/tai GPU-resursseja). Mieti myös, tarvitsetko todella nopeutta vai vain paljon näytteistystä. Näytteistystä voidaan nopeuttaa ensemble-simulaatioilla, joissa useita toisistaan riippumattomia trajektoreja (esim. sama järjestelmä tasapainotettuna eri alkuarvoisista nopeuksista) ajetaan samanaikaisesti. Lisätietoja on kohdassa Amberin suuren läpimenon simuloinnit.
Jos haluat käyttää useita GPU:ita, tee skaalaustesti varmistaaksesi, että
ajot todella nopeutuvat, ja käytä binääriä, jonka pääte on .cuda.MPI tai
.hip.MPI. Nyrkkisääntönä on, että kun resurssit kaksinkertaistetaan,
suorituskyvyn pitäisi kasvaa vähintään 1,5-kertaiseksi. Yleisiä
suorituskykytietoja löytyy
Amberin vertailuajojen skaalaustiedoista.
Tyypillisesti paras tehokkuus saavutetaan yhdellä GPU:lla.
Usealla GPU:lla ajaminen LUMIssa hyötyy GPU-sidonnasta. Yllä olevassa koko
solmun esimerkissä bittimaskia käytetään sitomaan CPU-ytimet optimaalisiin
(yhdistettyihin) GPU:ihin sekä sulkemaan pois ensimmäinen CPU-ydin
jokaisessa 8 ytimen ryhmässä (ne on varattu käyttöjärjestelmälle eivätkä
siksi ole käytettävissä laskentaan). Taustatietoja ja lisäohjeita löytyy
LUMIn dokumentaatiosta.
Huomaa, että CPU/GPU-sidonta on mahdollista vain varattaessa kokonaisia
solmuja (standard-g).
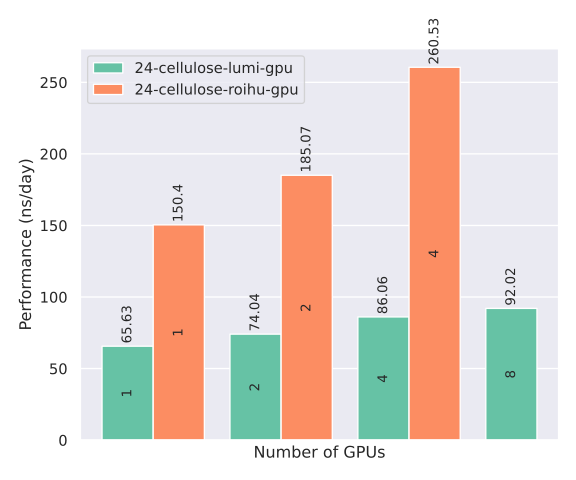
Amberin suorituskykyvertailu Roihu-GPU:n ja LUMI-G:n välillä on esitetty alla olevassa kuvassa. Vertailuajo on 408k atomin selluloosajärjestelmä (2 fs:n aika-askel). GPU-kohtainen suorituskyky Roihussa on yli kaksinkertainen LUMI-G:hen verrattuna. Huomaa kuitenkin, että tämä järjestelmä on liian pieni skaalautumaan tehokkaasti usealle GPU:lle. Useimmissa tapauksissa Amber kannattaa ajaa vain yhdellä GPU:lla.
Yksinkertaisuuden vuoksi termiä GPU käytetään tässä sekä Roihun GH200-superpiireistä että LUMIn MI250X GCD:istä.
Interaktiiviset ajot
Joskus pieniä töitä, kuten järjestelmän valmisteluja, on kätevämpää ajaa interaktiivisesti. Interaktiiviset ajot estävät kirjautumissolmun liiallisen kuormituksen, ja niitä tulisi käyttää tällaisissa tapauksissa. Voit pyytää komentotulkin laskentasolmulta HPC:n selainkäyttöliittymissä, komentoriviltä sinteractive-komennolla tai manuaalisesti komennolla:
Kun sinulle on varattu resurssit (voit joutua odottamaan), voit suorittaa
esimerkiksi paramfit-tehtävän suoraan komennolla:
Amberin suuren läpimenon laskenta
Samoin kuin GROMACSin multidir, Amberissa on sisäänrakennettu "multi-pmemd"-toiminnallisuus, jonka avulla voit ajaa useita MD-simulaatioita yhden Slurm-varauksen sisällä. Tämä on tehokas vaihtoehto tilanteissa, joissa haluat ajaa monia samankaltaisia mutta toisistaan riippumattomia simulaatioita. Tyypillisiä käyttötapauksia ovat tehostetun näytteistyksen menetelmät, kuten replica exchange MD. Lisäksi, koska Amber-simulaatiot eivät yleensä skaalaudu kovin hyvin usealle GPU:lle, monisimulaatioita voidaan käyttää suoraviivaisena menetelmänä näytteistyksen nopeuttamiseen käynnistämällä useita eri tavoin alustettuja kopioita järjestelmästäsi siten, että ne kaikki ajavat samanaikaisesti kukin yhdellä GCD:llä. Jos järjestelmäsi on hyvin pieni eikä siksi pysty hyödyntämään GCD:n täyttä kapasiteettia, voi olla jopa järkevää ajaa useita replikoita samalla GCD:llä tehokkuuden maksimoimiseksi.
Huom.
GPU-resurssit Roihussa ovat niukat, joten suosittelemme ajamaan laajamittaiset multi-pmemd-simulaatiot vain LUMIssa. LUMI-G:ssä on käytettävissä valtava GPU-kapasiteetti, joka on myös hinnoiteltu edullisemmin verrattuna Roihuun.
Esimerkki multi-pmemd-eräskriptistä LUMI-G:lle on alla.
#!/bin/bash
#SBATCH --account=<project>
#SBATCH --partition=standard-g
#SBATCH --time=01:00:00
#SBATCH --nodes=2
#SBATCH --ntasks-per-node=8
#SBATCH --gpus-per-node=8

export OMP_NUM_THREADS=${SLURM_CPUS_PER_TASK:-1}
export MPICH_GPU_SUPPORT_ENABLED=1

module use /appl/local/csc/modulefiles
module load amber/24-gpu

cat << EOF > select_gpu
#!/bin/bash

export ROCR_VISIBLE_DEVICES=\$SLURM_LOCALID
exec \$*
EOF

chmod +x ./select_gpu

CPU_BIND="mask_cpu:fe000000000000,fe00000000000000"
CPU_BIND="${CPU_BIND},fe0000,fe000000"
CPU_BIND="${CPU_BIND},fe,fe00"
CPU_BIND="${CPU_BIND},fe00000000,fe0000000000"

srun --cpu-bind=$CPU_BIND ./select_gpu pmemd.hip.MPI -ng 16 -groupfile groupfile
Tässä esimerkissä 16 järjestelmän kopiota ajetaan samanaikaisesti yhden
Amber-työn sisällä, kukin käyttäen yhtä GCD:tä. Yhteensä pyydetään 2 solmua,
koska jokainen LUMI-G:n solmu sisältää 8 GCD:tä (4 GPU:ta). Kunkin simulaation
syöte-, tuloste-, topologia- ja koordinaattitiedostot määritellään niin
sanotussa groupfile-tiedostossa:
-O -i mdin.GPU -o mdout000.GPU -p system000.prmtop -c system000.inpcrd
-O -i mdin.GPU -o mdout001.GPU -p system001.prmtop -c system001.inpcrd
-O -i mdin.GPU -o mdout002.GPU -p system002.prmtop -c system002.inpcrd
-O -i mdin.GPU -o mdout003.GPU -p system003.prmtop -c system003.inpcrd
-O -i mdin.GPU -o mdout004.GPU -p system004.prmtop -c system004.inpcrd
-O -i mdin.GPU -o mdout005.GPU -p system005.prmtop -c system005.inpcrd
-O -i mdin.GPU -o mdout006.GPU -p system006.prmtop -c system006.inpcrd
-O -i mdin.GPU -o mdout007.GPU -p system007.prmtop -c system007.inpcrd
-O -i mdin.GPU -o mdout008.GPU -p system008.prmtop -c system008.inpcrd
-O -i mdin.GPU -o mdout009.GPU -p system009.prmtop -c system009.inpcrd
-O -i mdin.GPU -o mdout010.GPU -p system010.prmtop -c system010.inpcrd
-O -i mdin.GPU -o mdout011.GPU -p system011.prmtop -c system011.inpcrd
-O -i mdin.GPU -o mdout012.GPU -p system012.prmtop -c system012.inpcrd
-O -i mdin.GPU -o mdout013.GPU -p system013.prmtop -c system013.inpcrd
-O -i mdin.GPU -o mdout014.GPU -p system014.prmtop -c system014.inpcrd
-O -i mdin.GPU -o mdout015.GPU -p system015.prmtop -c system015.inpcrd
Katso lisätietoja multi-pmemdistä Amberin käyttöoppaasta.
Viitteet
Kun viittaat Amberiin tai AmberToolsiin, käytä seuraavaa:
D.A. Case, H.M. Aktulga, K. Belfon, I.Y. Ben-Shalom, J.T. Berryman, S.R. Brozell, D.S. Cerutti, T.E. Cheatham, III, G.A. Cisneros, V.W.D. Cruzeiro, T.A. Darden, N. Forouzesh, M. Ghazimirsaeed, G. Giambaşu, T. Giese, M.K. Gilson, H. Gohlke, A.W. Goetz, J. Harris, Z. Huang, S. Izadi, S.A. Izmailov, K. Kasavajhala, M.C. Kaymak, A. Kovalenko, T. Kurtzman, T.S. Lee, P. Li, Z. Li, C. Lin, J. Liu, T. Luchko, R. Luo, M. Machado, M. Manathunga, K.M. Merz, Y. Miao, O. Mikhailovskii, G. Monard, H. Nguyen, K.A. O'Hearn, A. Onufriev, F. Pan, S. Pantano, A. Rahnamoun, D.R. Roe, A. Roitberg, C. Sagui, S. Schott-Verdugo, A. Shajan, J. Shen, C.L. Simmerling, N.R. Skrynnikov, J. Smith, J. Swails, R.C. Walker, J. Wang, J. Wang, X. Wu, Y. Wu, Y. Xiong, Y. Xue, D.M. York, C. Zhao, Q. Zhu, and P.A. Kollman (2024), Amber 2024, University of California, San Francisco.
Lisätietoja
Amberin kotisivulla on laaja käyttöopas ja hyödyllisiä opetusohjelmia.