Kuinka saavuttaa parempi I/O-suorituskyky Lustressa
Page undergoing cleanup after Puhti and Mahti retirement
This page contains outdated references to Puhti and/or Mahti, which have now been decommissioned. The page is undergoing changes to reflect CSC's new supercomputer Roihu.
Tässä ohjeessa käsittelemme joitakin rinnakkaisen I/O:n teknisiä yksityiskohtia ja annamme esimerkkejä paremman suorituskyvyn saavuttamiseksi. Huomaa myös CSC:n supertietokoneissa käytössä olevan Lustren tiedostojärjestelmän tekninen kuvaus.
MPI-I/O
Kun rinnakkaista I/O:ta tehdään MPI:llä (tai kirjastoilla, jotka käyttävät taustalla MPI-IO:ta), levyä voidaan käyttää itsenäisesti tai kollektiivisesti. Itsenäisessä I/O:ssa kukin MPI-prosessi käyttää tiedostojärjestelmää suoraan, kun taas kollektiivisessa I/O:ssa MPI-ajonaikainen ympäristö kokoaa/hajauttaa datan joukolla aggregaattori-I/O-tehtäviä. Kollektiivinen I/O tarjoaa yleensä huomattavasti suuremman kaistanleveyden kuin itsenäinen I/O.
- Esimerkki: 8 MPI-prosessia, 4 MPI-prosessia laskentasolmua kohti, kollektiivinen I/O, kaikki prosessit kirjoittavat samaan tiedostoon.
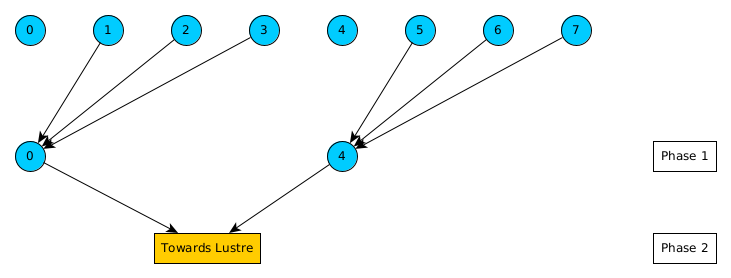
Esimerkki MPI-IO-aggregaattoreista
I/O:n parantaminen ROMIO-vihjeillä
Oletusarvoisesti kollektiivisessa I/O:ssa Mahdin OpenMPI käyttää yhtä MPI I/O -agregaattoria laskentasolmua kohti. Tämä tarkoittaa, että yllä olevassa esimerkissämme vain 2 MPI-prosessia tekevät varsinaisen I/O:n. Ne keräävät datan muilta prosesseilta (vaihe 1), ja toisessa vaiheessa ne lähettävät datan tallennukseen. Oletusarvoisten MPI-aggregaattorien käyttö voi olla riittävää, mutta monissa tapauksissa ei ole. Aggregaattorien määrää solmua kohti sekä joitakin muita I/O:hon vaikuttavia parametreja voidaan säätää ROMIO-vihjeillä.
Saatavilla olevat vihjeet kollektiiviseen puskurointiin (kaksivaiheinen I/O), painopisteenä Lustre:
| Hint | Description |
|---|---|
| cb_buffer_size | Välipuskurin koko tavuina, jota käytetään kaksivaiheisessa kollektiivisessa I/O:ssa |
| romio_cb_read | Kollektiiviset lukuoperaatiot kollektiivisen puskuroinnin aikana, arvot: enable, disable, automatic |
| romio_cb_write | Kollektiiviset kirjoitusoperaatiot kollektiivisen puskuroinnin aikana, arvot: enable, disable, automatic |
| romio_no_indep_rw | Määrittää, onko itsenäinen luku/kirjoitus poistettu käytöstä vai ei, arvot: enable, disable, automatic |
| cb_config_list | Määrittää, kuinka monta MPI I/O -aggregaattoria voidaan käyttää solmua kohti, arvot: *:X, missä X aggregaattoria kutakin laskentasolmua kohti |
| cb_nodes | Käytettävien aggregaattorien enimmäismäärä |
Kuinka voin muuttaa MPI I/O -vihjeitä?
Vihjeet voidaan määritellä tekstitiedostossa. Esimerkiksi MPI I/O -aggregaattorien määrä solmua kohti asetetaan kahteen:
Lisäksi ympäristömuuttuja ROMIO_HINTS täytyy asettaa
eräajotyöskriptissäsi:
Vihjeet voidaan asettaa myös sovelluskoodissa:
...
call MPI_Info_create(info,ierror)
call MPI_Info_set(info,'romio_cb_write','enable',ierror)
...
call MPI_File_open(comm,filename,amode,info,fh,ierror)
...
Jotta voit tarkistaa, että määrityksesi todella otettiin käyttöön, käytetyt vihjeet ja niiden arvot voidaan näyttää asettamalla eräajotyöskriptiin:
Jos, ja vain jos, käytössä on kollektiivinen I/O, vihjeet tulostetaan työn vakiotulosteeseen, esimerkiksi:
key = cb_buffer_size            value = 33554432
key = romio_cb_read             value = enable
key = romio_cb_write            value = enable
key = cb_nodes                  value = 64
key = romio_no_indep_rw         value = false
key = romio_cb_pfr              value = disable
...
Tiedosto prosessia kohti
Jotkin sovellukset luovat yhden tiedoston jokaista MPI-prosessia kohti. Vaikka tämä on helppo toteuttaa, se ei välttämättä ole tehokasta. Jos käytät paljon prosesseja laskentasolmua kohti, voi syntyä kilpailua sekä solmun verkosta (koska kaikkien prosessien täytyy käyttää tiedostojärjestelmää) että varsinaisista I/O-operaatioista. Joissakin tapauksissa tiedosto prosessia kohti voi olla tehokas lähestymistapa, mutta ole aina varovainen ja mieti skaalautuvuutta, sillä tämä lähestymistapa ei skaalaudu.
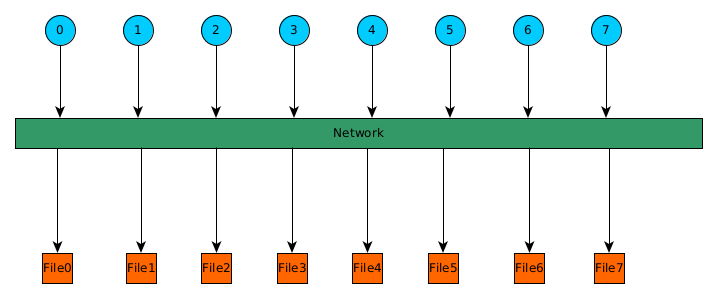
Tiedosto prosessia kohti
Vertailutesti - NAS BTIO
Estävä I/O
Testaustarkoituksiin käytämme NAS BTIO -vertailutestiä, jossa on PnetCDF-tuki, testataksemme I/O-suorituskykyä Mahdin 16 laskentasolmulla.
Luomme syötetiedoston seuraavasti:
w                  # IO mode:    w for write, r for read
2                  # IO method:  0 for MPI collective I/O, 1 for MPI_independent I/O,
                   # 2 for PnetCDF blocking I/O, 3 for PnetCDF nonblocking I/O
5                  # number of time steps
2048 1024 256      # grid_points(1), grid_points(2), grid_points(3)
/scratch/project_xxxxx/BTIO/output # output filew
Tämä tarkoittaa, että teemme kirjoitusoperaatioita estävällä PnetCDF:llä, 5 aika-askeleella ja yhteensä lähes puolella miljardilla hilapisteellä. Tulostiedosto on lähes 105 GB. Käytämme 256 prosessia, 16 prosessia laskentasolmua kohti.
Kun suoritetaan oletusasetuksilla, vertailutestin tulosteesta saadaan:
Juovitus
Tiedämme, että Lustren juovitus on 1 MB, joten asetamme tämän tiedostoon nimeltä
romio
ja annamme ROMIO-vihjeen:
Kun vertailutesti suoritetaan uudelleen, saamme:
Suorituskyky paranee kertoimella 2,27.
MPI I/O -aggregaattorit
Oletusarvoisesti laskentasolmua kohti on yksi MPI I/O -aggregaattori, joten
lisäämme määrän kahteen lisäämällä romio-tiedostoon:
Kun vertailutesti suoritetaan uudelleen, saamme nyt:
Suorituskyky paranee kokonaisuudessaan kertoimella 2,86.
Lustren OST:ien määrän kasvattaminen
Jos käytämme kahta Lustren OST:tä ilman ROMIO-vihjeitä, suorituskyky on 3500 MiB/s, mikä on vähemmän kuin edellinen tulos.
Kun käytetään 2:ta OST:tä romio-tiedoston kanssa
suorituskyky kasvaa 4667 MiB/s:iin, eli kasvu on 33 %. Tässä tapauksessa aggregaattorien määrän kasvattaminen ei paranna suorituskykyä.
Yleisesti ottaen ROMIO-vihjeiden vaikutus riippuu sovelluksesta ja käytetystä laitteistosta; optimaaliset parametrit eivät välttämättä ole samoja eri sovelluksissa.
Estämätön I/O
Luomme syötetiedoston estämättömälle PnetCDF:lle seuraavasti:
w                  # IO mode:    w for write, r for read
3                  # IO method:  0 for MPI collective I/O, 1 for MPI_independent I/O,
                   # 2 for PnetCDF blocking I/O, 3 for PnetCDF nonblocking I/O
5                  # number of time steps
2048 1024 256      # grid_points(1), grid_points(2), grid_points(3)
/scratch/project_xxxxx/BTIO/output # output file
ROMIO:n oletusparametreilla suorituskyky on 1820 MiB/s yhdellä OST:llä, mikä on melko alhainen 16 laskentasolmulle.
Seuraavaksi määritämme romio-tiedoston:
Saavutettu suorituskyky on 4565 MiB/s, mikä on 2,5-kertainen parannus.
Jos käytämme 2:ta OST:tä samalla romio-tiedostolla, suorituskyky on
9520 MiB/s, mikä on yli kaksinkertainen verrattuna yhteen OST:hen ja yli
kaksinkertainen verrattuna estävään I/O:hon. Oletusparametreilla saavutettu
suorituskyky olisi 7772 MiB/s, joten vihjeet parantavat suorituskykyä 22,5 %.