TURBOMOLE
TURBOMOLE on nopea ja vakaa kvanttikemian ohjelmistopaketti, jossa on erittäin tehokkaat toteutukset useille laskennallisille menetelmille (HF/DFT/MP2/CC). Ominaisuuksia voidaan laskea sekä perustiloille että viritystiloille. TURBOMOLE on suunniteltu suurten järjestelmien tehokkaaseen tutkimukseen.
Saatavuus
- Roihu-CPU: 8.0
Lisenssi
- Voit käyttää ohjelmistoa ainoastaan voittoa tavoittelemattomaan tutkimukseen.
- Vain akateemisten (eli tutkintoja myöntävien) instituutioiden käyttäjät saavat käyttää ohjelmistoa.
Käyttö
Alusta TURBOMOLE-ympäristö:
Roihussa työt on lähetettävä CPU-kirjautumissolmulta (roihu-cpu).
Moduuli asettaa automaattisesti muuttujat I_MPI_FABRICS=shm:ofi ja MPI_USESRUN=1.
Manuaalista PATH- tai MPI-asetusta ei tarvita alla olevissa eräajoesimerkeissä
näytetyn lisäksi. Täydellinen luettelo käytettävissä olevista partitioista on
sivulla Roihun eräajopartiot.
Eräajoskriptit
Roihussa moduuli asettaa MPI_USESRUN=1, joten TURBOMOLE käynnistää tehtävät
automaattisesti srun-komennolla. Erillistä wrapper-skriptiä ei tarvita.
Note
Paikallinen NVMe-levy ei ole vielä käytettävissä Roihun tavallisissa M-solmutöissä. Scratch-I/O ohjautuu Lustreen. NVMe-tuki otetaan käyttöön tulevassa päivityksessä.
#!/bin/bash
#SBATCH --partition=small         # see batch-job-partitions for all options
#SBATCH --nodes=1
#SBATCH --ntasks-per-node=12      # MPI tasks per node
#SBATCH --mem-per-cpu=2000        # MB per CPU core
#SBATCH --account=<project>       # insert here the project to be billed
#SBATCH --time=01:00:00           # time as hh:mm:ss
export PARA_ARCH=MPI
module load turbomole/8.0
export SLURM_CPU_BIND=none
export PATH=$TURBODIR/bin/$(sysname):$PATH
export TURBOTMPDIR=/scratch/<project>/<user>/TM_TMPDIR/$SLURM_JOB_ID
mkdir -p $TURBOTMPDIR
export PARNODES=$SLURM_NTASKS
jobex -ri -c 300 > jobex.out
#!/bin/bash
#SBATCH --partition=small         # see batch-job-partitions for all options
#SBATCH --nodes=1
#SBATCH --cpus-per-task=12        # SMP threads
#SBATCH --mem-per-cpu=2000        # MB per CPU core
#SBATCH --account=<project>       # insert here the project to be billed
#SBATCH --time=01:00:00           # time as hh:mm:ss
export PARA_ARCH=SMP
module load turbomole/8.0
export PATH=$TURBODIR/bin/$(sysname):$PATH
export TURBOTMPDIR=/scratch/<project>/<user>/TM_TMPDIR/$SLURM_JOB_ID
mkdir -p $TURBOTMPDIR
export PARNODES=$SLURM_CPUS_PER_TASK
export OMP_NUM_THREADS=$SLURM_CPUS_PER_TASK
jobex -ri -c 300 > jobex.out
Note
Toisinaan mpshift-laskennat keskeytyvät, koska paikallinen /tmp
täyttyy. Ongelma voidaan kiertää määrittelemällä $TMPDIR uudelleen:
Note
Erityisesti jotkin aaltofunktiopohjaiset elektronikorrelaatiomenetelmät voivat olla hyvin levy-I/O-intensiivisiä. Paikallisen levyn käyttö tällaisissa töissä vähentää Lustre-rinnakkaistiedostojärjestelmän kuormitusta. Roihussa paikallinen NVMe ei ole vielä käytettävissä tavallisissa M-solmutöissä.
Suorituskykyesimerkki
Tässä annamme lyhyen esimerkin siitä, miten erilaiset resurssivaraukset vaikuttavat TURBOMOLEn suorituskykyyn. Käytämme syöterakenteena α-tokoferolia (E-vitamiini, C29H50O2, 81 atomia). Geometria on saatavilla tiedostossa vite_wb97x_d4_roihu.sh.
Testit tehtiin tuotantoympäristössä, jossa muiden töiden vaikutus voi aiheuttaa suorituskyvyn vaihtelua.
Seuraava kuva näyttää ωB97X-D4/def2-TZVP-yksittäispiste-energialaskennan seinäkelloajan Roihussa ytimien/säikeiden määrän funktiona käyttäen sekä SMP- (OpenMP) että MPI-rinnakkaisuutta.
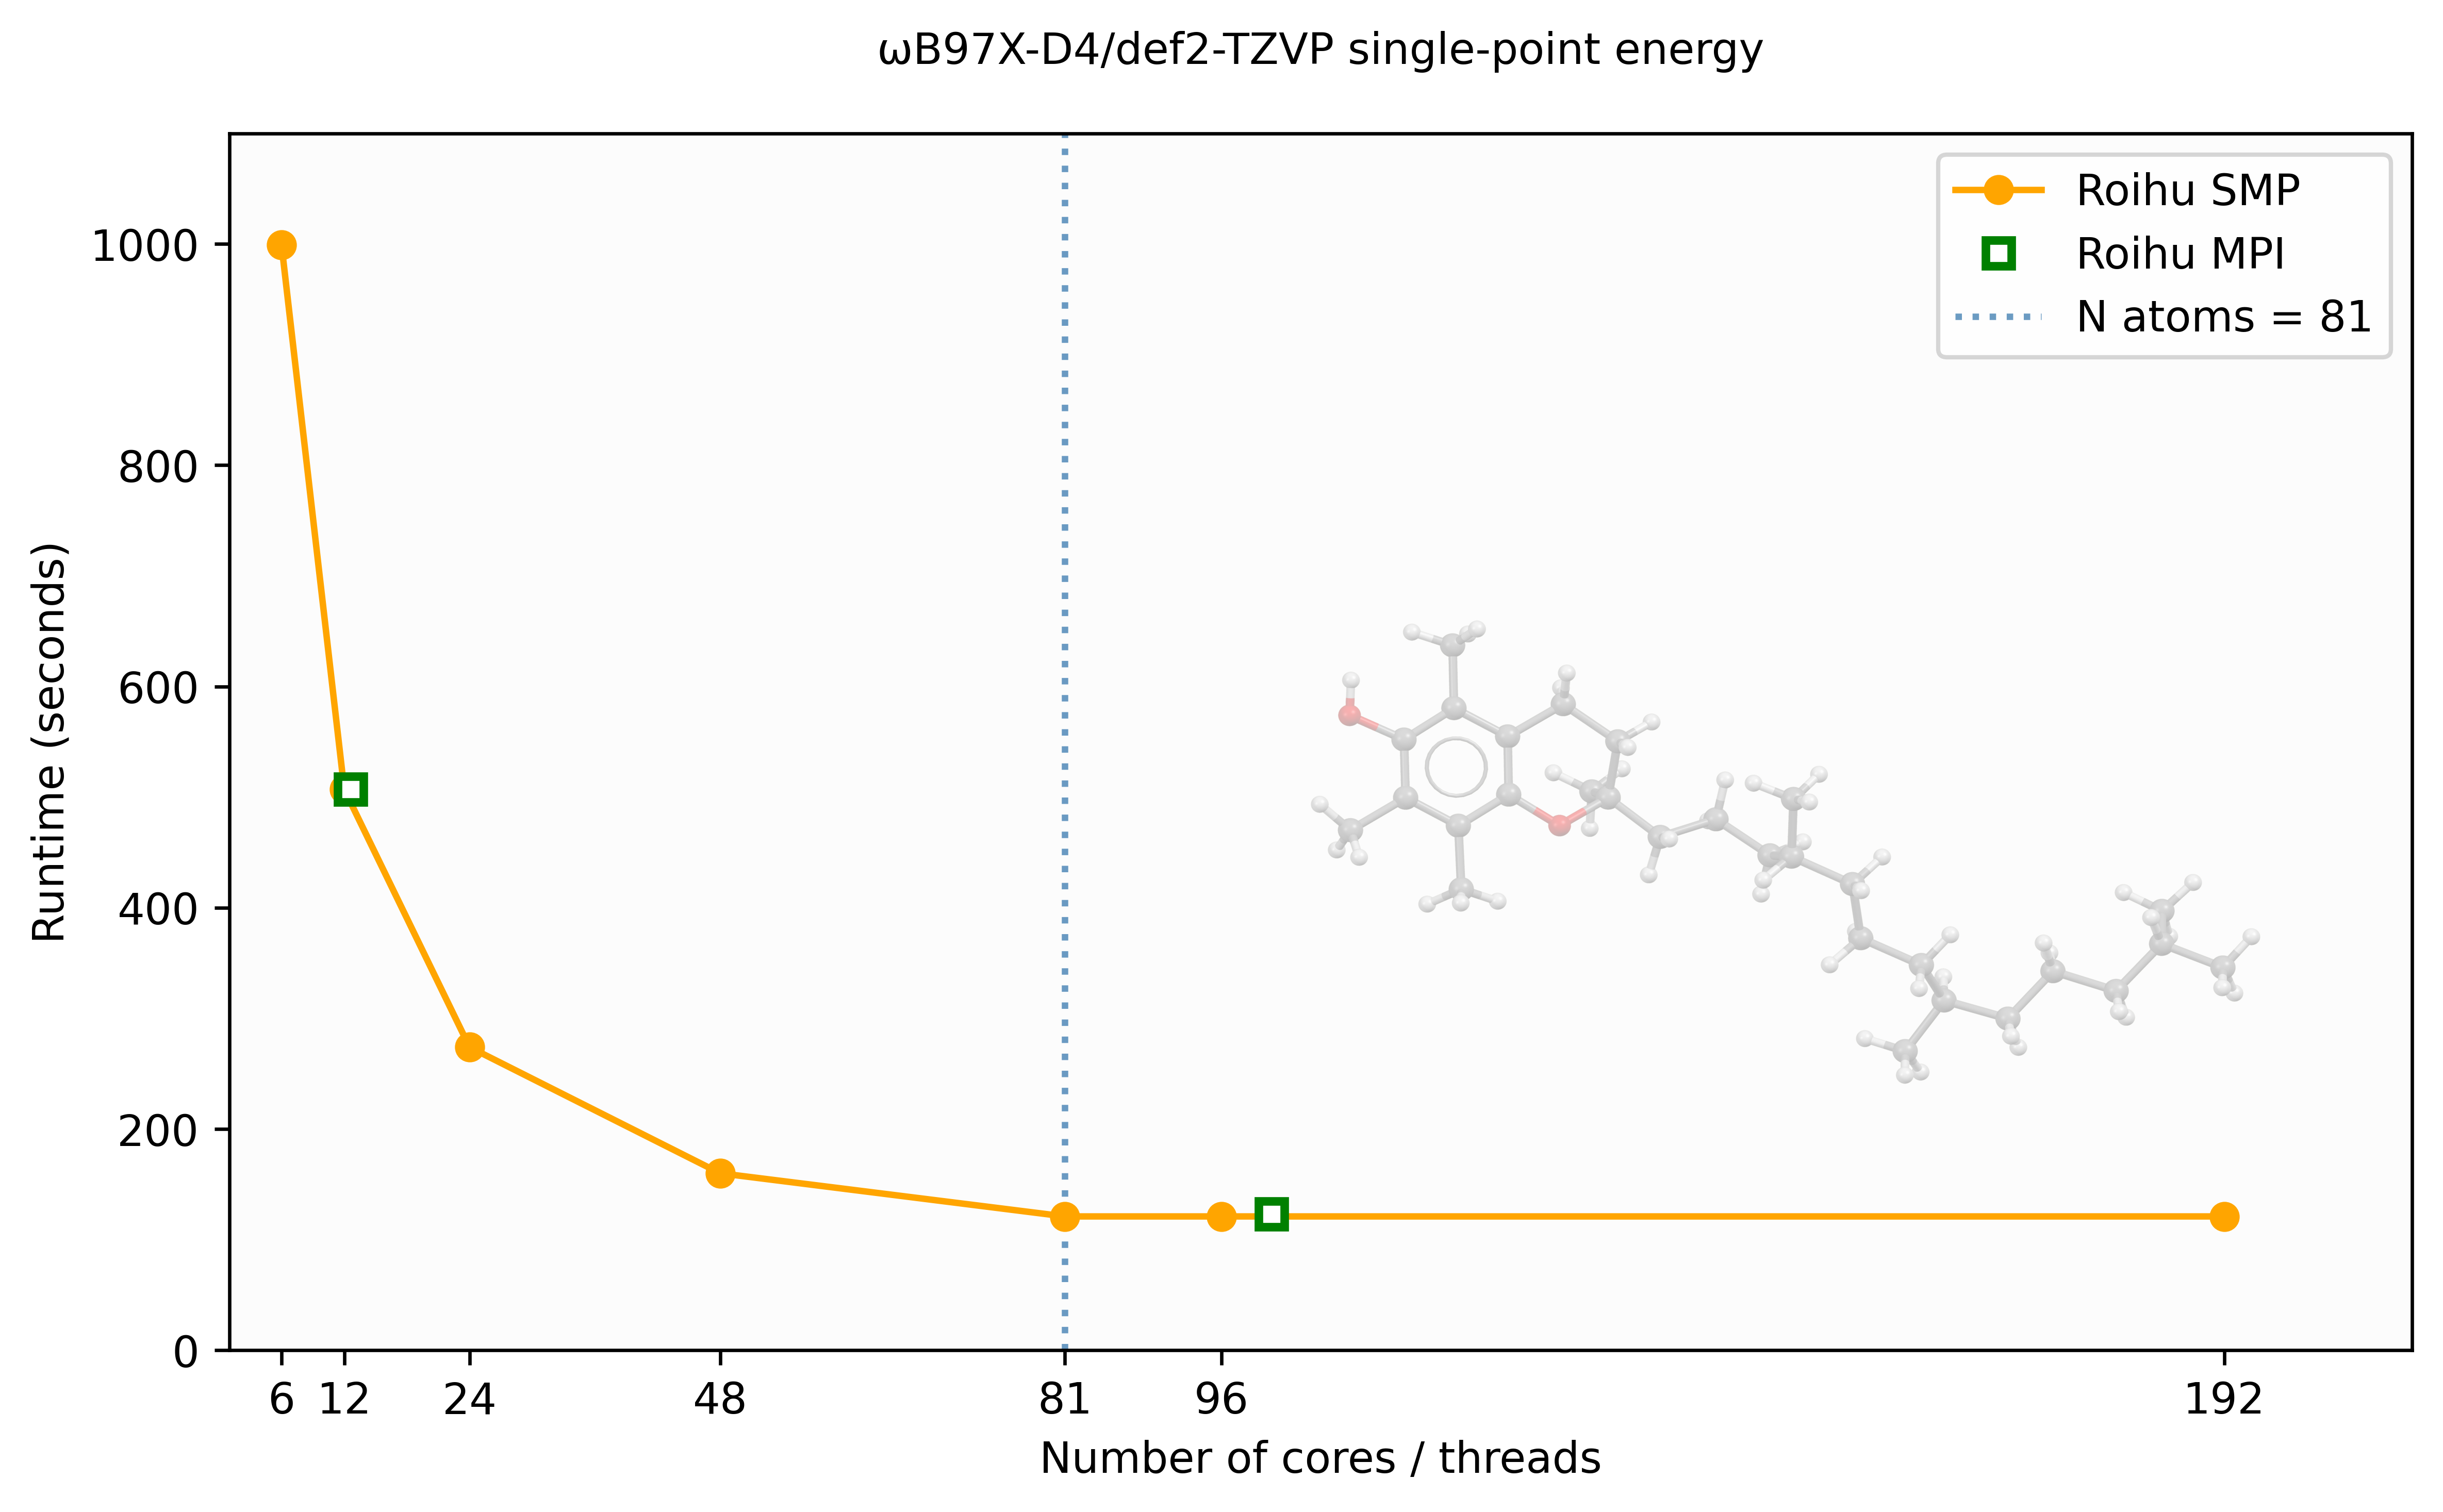
SMP (PARA_ARCH=SMP) skaalautuu hyvin noin 48 säikeeseen asti tässä
81 atomin järjestelmässä, minkä jälkeen suorituskyky tasaantuu. MPI:n
(PARA_ARCH=MPI) tulokset näyttävät samanlaisia seinäkelloaikoja kuin SMP,
mutta vaativat huomattavasti enemmän muistia — noin 15 kertaa enemmän
96 prosessilla tässä järjestelmässä.
Yhden solmun ridft-DFT-laskennoissa SMP on siksi yleensä MPI:tä parempi
vaihtoehto. Skaalautuvuuden raja liittyy atomien määrään — suuremmat molekyylit
hyötyvät useammista säikeistä ennen kyllästymispisteen saavuttamista.
Työn valmistuttua tarkista todellinen muistin ja seinäkelloajan käyttö komennolla:
NumForce-laskennat
NumForce on työkalu, jolla voidaan laskea toisia derivaattoja (molekulaarinen
Hessen matriisi) kaikille menetelmille, joille TURBOMOLEssa on saatavilla
analyyttiset gradientit. NumForce-työ käynnistää 3*N*2 (N = atomien määrä)
toisistaan riippumatonta gradienttilaskentaa. Yleensä on tehokkainta ajaa
yksittäiset gradienttilaskennat sarjallisina (unset PARA_ARCH). Kunkin
sarjallisen laskennan odotetaan kestävän suunnilleen saman ajan, joten
optimaalisesti gradienttilaskentojen kokonaismäärän tulisi olla varattujen
ytimien kokonaislukukerrannainen.
NumForce-vaihe työtiedostossa:
unset PARA_ARCH
export HOSTS_FILE=$PWD/turbomole.machines
rm -f $HOSTS_FILE
srun hostname > $HOSTS_FILE
ulimit -s unlimited
kdg tmpdir
NumForce -ri -central -mfile $HOSTS_FILE > NumForce.out
Viitteet
Mainitse käytetty ohjelmistopaketti viitatessasi versionumero huomioiden:
- TURBOMOLE V8.0, a development of University of Karlsruhe and Forschungszentrum Karlsruhe GmbH, 1989-2007, TURBOMOLE GmbH, since 2007; available from https://www.turbomole.org
- Myös katsausartikkeli tulisi mainita: https://doi.org/10.1063/5.0004635
- Tieteelliset julkaisut edellyttävät käytettyjen menetelmien ja prosessien asianmukaista viittaamista. TURBOMOLE-moduulien tulosteotsikot sisältävät asiaankuuluvat artikkelit.